RAG (Retrieval-Augmented Generation, "יצירה מועשרת באחזור") היא שיטה שבה מודל שפה עונה על שאלה בעזרת מידע ששולפים בשבילו באותו רגע ממאגר מסמכים — במקום להסתמך רק על מה שהוא "זוכר" מהאימון. כך צ'אטבוט של עסק יכול לענות על שעות פעילות, מדיניות החזרות או מפרט מוצר מתוך המסמכים של העסק עצמו, ולהתעדכן כשהמסמכים משתנים.
המונח הופיע במאמר Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Patrick Lewis ושותפים, 2020), שהציע לשלב את הידע הפנימי של מודל עם מאגר מסמכים חיצוני שאפשר לחפש בו תוך כדי יצירת הטקסט.
למה לא פשוט לשאול את המודל
מודל שפה כללי לא מכיר את העסק שלכם. הוא לא יודע מה המחיר של השירות, מתי אתם סגורים בחגים או מה כתוב במדיניות הביטול. כשהוא לא יודע, הוא עלול לנחש — ולנסח את הניחוש בביטחון מלא. RAG מצמצם את הבעיה: לפני שהמודל עונה, המערכת מוצאת את הקטעים הרלוונטיים מהמידע שלכם ומבקשת מהמודל לענות על סמך מה שנשלף.
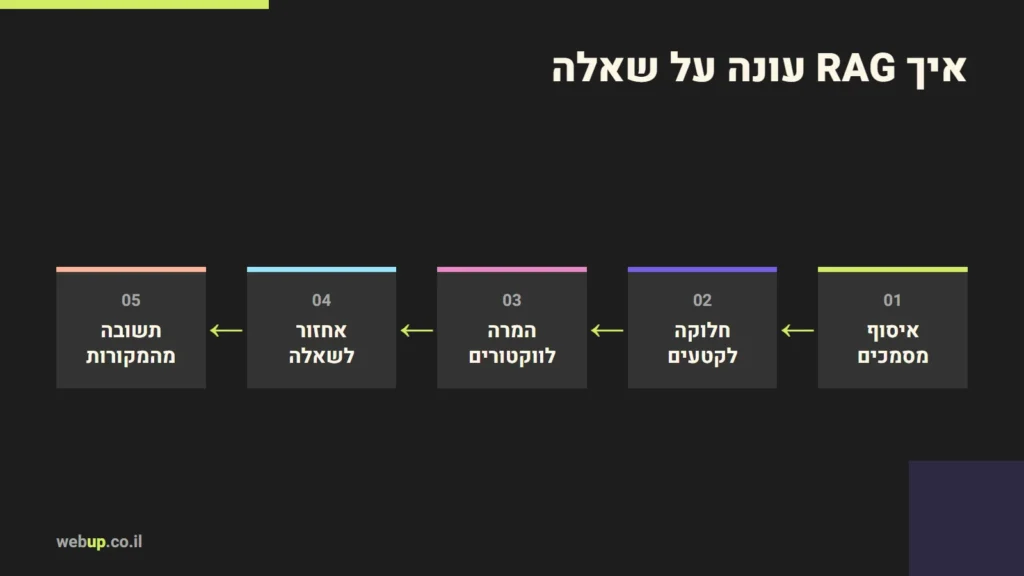
איך זה עובד — בחמישה שלבים
- איסוף: מרכזים את מקורות המידע — עמודי האתר, מסמכי PDF, שאלות נפוצות, מדיניות.
- חלוקה: מחלקים כל מסמך לקטעים קצרים (chunks), כדי שאפשר יהיה לשלוף בדיוק את הפסקה הנכונה.
- המרה לווקטורים: כל קטע מומר לייצוג מספרי (embedding) שמבטא את המשמעות שלו, ונשמר במאגר.
- אחזור: כשמגיעה שאלה, גם היא מומרת לווקטור, והמערכת מוצאת את הקטעים הקרובים ביותר במשמעות.
- יצירה: המודל מקבל את השאלה ואת הקטעים שנשלפו, עם הוראה לענות על סמך המידע הזה בלבד — ולומר "אני לא יודע" כשאין שם תשובה.
RAG מול אימון מחדש (fine-tuning)
| RAG | אימון מחדש | |
|---|---|---|
| מה משתנה | המידע שנשלף לכל שאלה | המודל עצמו |
| עדכון מידע | מעדכנים מסמך — והתשובות מתעדכנות | צריך לאמן שוב |
| מקור לתשובה | אפשר להציג מאיזה מסמך הגיעה | קשה לדעת |
| מתאים ל | ידע עסקי שמשתנה: מחירים, מדיניות, קטלוג | סגנון, פורמט, משימה מאוד ספציפית |
לרוב העסקים, RAG הוא הבחירה הנכונה: הוא זול יותר לתחזוקה, והמידע נשאר בשליטה שלכם.
מה קובע אם זה יעבוד טוב
איכות המידע
RAG לא מתקן מידע גרוע. אם בעמוד אחד באתר כתוב שהמשלוח לוקח שלושה ימים ובמסמך אחר חמישה — הבוט עלול לענות כל פעם משהו אחר. לפני שמחברים, מסדרים את המקורות: גרסה אחת לכל עובדה, בלי מסמכים ישנים.
חלוקה נכונה
קטעים ארוכים מדי מכניסים רעש; קצרים מדי מאבדים הקשר. טבלת מחירים שנחתכה באמצע או שאלה שהופרדה מהתשובה שלה — הן סיבה נפוצה לתשובות שגויות.
הוראות ברורות למודל
"ענה רק מתוך המידע שסופק", "אם אין תשובה — אמור שאינך יודע והצע לפנות לנציג", "אל תציין מחירים שלא מופיעים במקורות". בלי הוראות כאלה, המודל ישלים פערים מהידע הכללי שלו.
מטמון ועלויות
שאלות חוזרות אפשר לשמור במטמון, כדי לא לשלם על אחזור ויצירה בכל פעם מחדש — בדומה למטמון באתר.
טעויות נפוצות
- "זרקנו את כל האתר פנימה" — כולל עמודי תגיות, פוטר ותפריטים, שמוסיפים רעש לכל קטע.
- אין דרך לעדכן — המאגר נבנה פעם אחת ולא מתעדכן כשהאתר משתנה.
- אין בדיקה — אף אחד לא מריץ רשימה קבועה של שאלות כדי לראות אם התשובות עדיין נכונות.
- מידע רגיש במאגר — מסמכים פנימיים או פרטי לקוחות שהבוט עלול לצטט לכל גולש.
מהניסיון שלי
ב-WebGPT, פלטפורמת ה-AI שבניתי ומפעיל, נוצרו יותר ממיליון צ'אטבוטים. מה שלמדתי מזה פשוט: מעט מאוד מהבעיות נובעות מהמודל. רובן נובעות ממידע לא מסודר, מחלוקה לא טובה, או מהוראות שלא אומרות לבוט מה לעשות כשהוא לא יודע.
שאלות נפוצות
RAG מונע לגמרי "הזיות"?
לא לגמרי. הוא מקטין אותן משמעותית כשהמידע טוב וההוראות ברורות, אבל צריך עדיין לבדוק תשובות ולהגביל נושאים רגישים.
אפשר לחבר RAG לאתר וורדפרס?
כן. העמודים נשלפים מהאתר (למשל דרך ה-REST API של וורדפרס), מעובדים למאגר, ומתעדכנים כשתוכן משתנה.
מה ההבדל בין RAG לחיפוש באתר?
חיפוש באתר מחזיר רשימת עמודים. RAG משתמש באותו רעיון של אחזור, אבל מנסח מהקטעים שנמצאו תשובה ישירה לשאלה.
מאמרים קשורים: בינה מלאכותית לעסקים קטנים: שימושים מעשיים סביב האתר — ומה לא למסור לכלי.
רוצים צ'אטבוט שעונה מתוך המידע של העסק, עם מקורות מסודרים ובקרה על מה שהוא אומר? פרטים על צ'אטבוט לאתר, ואפשר לספר לי על המידע שיש לכם — אני בונה חיבורים כאלה במסגרת אינטגרציות ו-API.
אהבתם את המאמר?