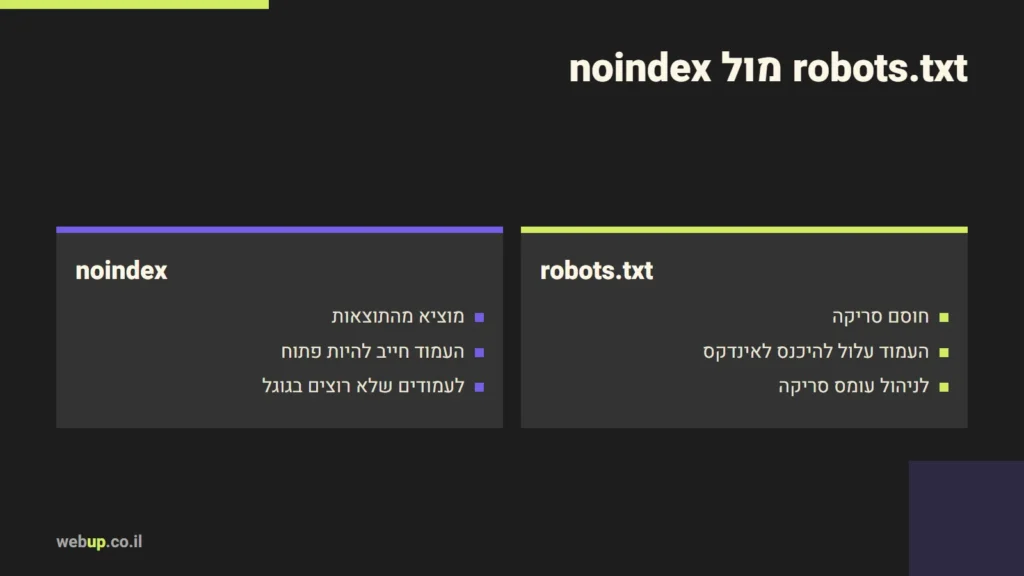
robots.txt הוא קובץ טקסט קטן שיושב בשורש האתר ואומר לסורקים של מנועי החיפוש לאילו כתובות מותר להם להיכנס ולאילו לא. הוא נועד בעיקר לנהל את תנועת הסורקים — למנוע עומס על השרת וסריקה מיותרת של אזורים חסרי ערך — ולא להסתיר עמודים מגוגל. זו הטעות הנפוצה ביותר סביב הקובץ, והיא יכולה להשאיר עמוד שרציתם להסתיר בתוצאות החיפוש, או להעלים עמוד שרציתם שיופיע.
מה robots.txt עושה — ומה לא
לפי התיעוד של גוגל, הקובץ קובע לאילו כתובות הסורק רשאי לגשת, והוא "לא מנגנון להוצאת עמוד מגוגל". עמוד שחסום ב-robots.txt עדיין יכול להופיע בתוצאות החיפוש אם אתרים אחרים מקשרים אליו — רק בלי תיאור, כי גוגל לא קראה את התוכן שלו.
| מה רוצים להשיג | הכלי הנכון |
|---|---|
| שגוגל לא תסרוק אזור חסר ערך (חיפוש פנימי, פרמטרים של סינון) | robots.txt |
| שעמוד לא יופיע בתוצאות החיפוש | תגית noindex — והעמוד חייב להיות פתוח לסריקה |
| שתוכן רגיש לא יהיה נגיש לאף אחד | סיסמה או הגבלת גישה בשרת |
| לאחד כמה כתובות של אותו תוכן | תג קנוניקל או הפניה 301 |
שימו לב לשורה השנייה: אם תחסמו עמוד ב-robots.txt וגם תשימו עליו noindex, גוגל לא תסרוק אותו — ולכן גם לא תראה את ה-noindex. השילוב הזה הוא בדיוק מה שמשאיר עמודים "תקועים" באינדקס.
איך נראה הקובץ
גוגל תומכת בארבע הוראות בלבד: user-agent, allow, disallow ו-sitemap. דוגמה לאתר וורדפרס עם חיפוש פנימי:
User-agent: *
Disallow: /?s=
Disallow: /search/

Sitemap: https://example.co.il/sitemap_index.xml
כמה כללים מהמפרט של גוגל:
- מיקום: הקובץ חייב לשבת בשורש הדומיין (/robots.txt). סורקים לא מחפשים אותו בתיקיות משנה, ולכל תת-דומיין יש קובץ משלו.
- גודל: גוגל קוראת עד 500KiB, ומתעלמת ממה שאחרי.
- מטמון: גוגל שומרת את הקובץ בדרך כלל עד 24 שעות — שינוי לא נכנס לתוקף מיד.
- crawl-delay לא נתמך בגוגל. אם השרת לא עומד בקצב הסריקה, הבעיה היא בשרת ולא בקובץ.
מה קורה כשהקובץ חסר או שבור
קובץ שמחזיר 404 הוא לא בעיה: גוגל מתייחסת לכל שגיאת 4xx (חוץ מ-429) כאילו אין הגבלות סריקה. שגיאת שרת (5xx) היא סיפור אחר — בשעות הראשונות גוגל עוצרת את סריקת האתר כולו, ובהמשך משתמשת בגרסה האחרונה ששמרה. כלומר, robots.txt שמחזיר שגיאת שרת יכול לעצור סריקה של אתר שלם. זו אחת הסיבות שאני בודק את הקובץ אחרי כל מעבר שרת, יחד עם שאר הסעיפים בצ׳קליסט להעברת אתר.
הטעויות שאני רואה הכי הרבה
- Disallow: / שנשאר מסביבת הפיתוח — האתר עלה לאוויר, והקובץ עדיין חוסם את הכול. בוורדפרס יש לזה גרסה מקבילה: ההגדרה שמבקשת ממנועי חיפוש לא לאנדקס את האתר, שנשארה מסומנת מתקופת הפיתוח.
- חסימת קבצי CSS ו-JavaScript — גוגל צריכה אותם כדי לרנדר את העמוד ולהבין אותו. חסימה כזו מזיקה יותר משהיא עוזרת.
- שימוש ב-robots.txt כדי "להסתיר" עמודים — כולל עמודי תודה, עמודי לקוחות או קבצים. הקובץ עצמו ציבורי, וכל אחד יכול לקרוא אותו — כך שרשימת "אזורים סודיים" בתוכו רק מסמנת אותם.
- חסימת עמודים שכבר באינדקס כדי להוציא אותם — הם נשארים, רק בלי תיאור. קודם
noindex, מחכים שהעמודים ייצאו, ורק אחר כך שוקלים חסימה.
מתי robots.txt באמת חשוב
באתר תדמית של עשרים עמודים, הקובץ כמעט לא משנה — גוגל תסרוק הכול בלי בעיה. הוא נעשה קריטי באתרים גדולים: אינדקסים, חנויות ופורטלים שמייצרים אלפי כתובות מסינונים, מיונים וחיפושים. שם, חסימה של דפוסי פרמטרים חסרי ערך היא חלק מניהול תקציב הסריקה, כך שהסורק יבזבז פחות זמן על וריאציות ויגיע מהר יותר לעמודים החדשים. פירטתי את זה במאמר עימוד וסינונים באתרים גדולים.
דוגמה: הקובץ באתר הזה
האתר הזה קטן, ולכן הקובץ שלו מינימלי: הוא לא חוסם דבר ומפנה למפת האתר. עמוד תוצאות החיפוש הפנימי לא חסום — הוא מסומן noindex, follow, כך שגוגל יכולה לראות את ההוראה ולא להכניס אותו לאינדקס.
איך בודקים
- פותחים את /robots.txt בדפדפן ומוודאים שאין חסימה גורפת.
- ב-Search Console, דוח robots.txt מראה איזו גרסה גוגל קראה ומתי, ושגיאות אם יש.
- כלי בדיקת הכתובות ב-Search Console מראה אם כתובת מסוימת חסומה לסריקה — ראו המדריך ל-Search Console.
שאלות נפוצות
האם חייבים robots.txt?
לא. בלי קובץ, גוגל פשוט מניחה שמותר לסרוק הכול. הוא שימושי כשיש אזורים שאין טעם לסרוק, וכדי להצביע על מפת האתר.
איך מוציאים עמוד מגוגל?
עם noindex בעמוד עצמו, כשהעמוד פתוח לסריקה, או עם מחיקה שמחזירה 404/410. robots.txt לא מוציא עמודים מהאינדקס. הרחבתי במאמר אינדוקס בגוגל.
האם כל הבוטים מכבדים את הקובץ?
הסורקים של מנועי החיפוש הגדולים — כן. בוטים זדוניים מתעלמים ממנו, ולכן הוא לא כלי אבטחה.
הגדרת robots.txt, מפות אתר ותגיות אינדוקס היא חלק מהתשתית הטכנית שאני בונה בכל אתר. רוצים שאבדוק מה הקובץ שלכם חוסם בפועל? שלחו לי את כתובת האתר.
אהבתם את המאמר?