אתר JavaScript הוא אתר שהתוכן שלו נבנה בדפדפן באמצעות קוד JavaScript — למשל אפליקציית React, Vue או Angular — ולא מגיע מוכן מהשרת. גוגל יודעת להריץ JavaScript ולקרוא אתרים כאלה, אבל התהליך ארוך ושביר יותר מאשר באתר שהשרת שלו מחזיר HTML מלא. ההבדל בין אתר JavaScript שגוגל מבינה לבין אתר שנשאר חצי ריק באינדקס הוא כמה החלטות ארכיטקטורה שמתקבלות בתחילת הפרויקט.
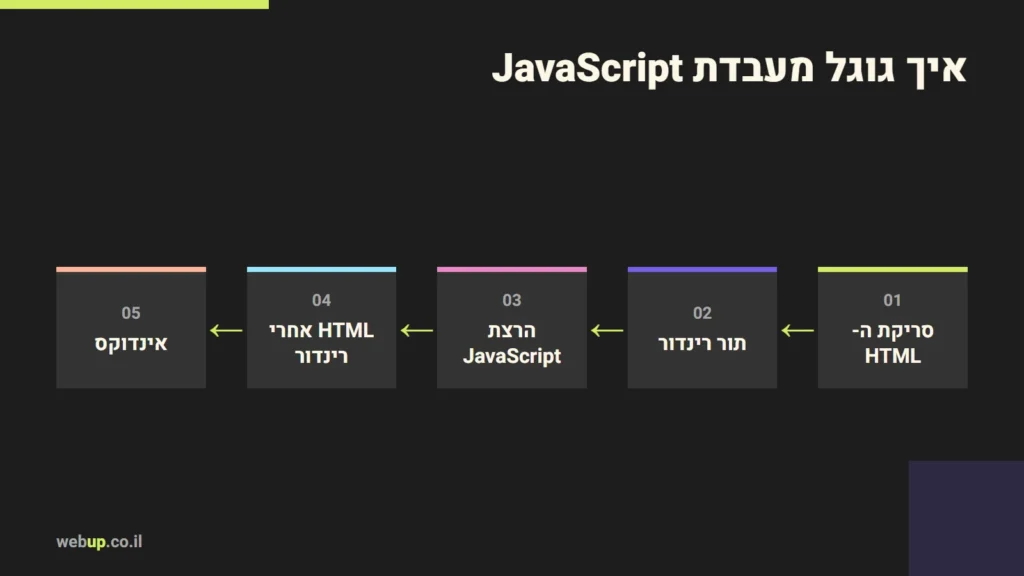
איך גוגל מעבדת אתר JavaScript
לפי המדריך של גוגל ל-JavaScript, העיבוד עובר שלושה שלבים:
- סריקה — Googlebot מוריד את ה-HTML שהשרת מחזיר.
- רינדור — העמוד נכנס לתור רינדור, ושם מריצים את ה-JavaScript ובונים את העמוד כמו בדפדפן. גוגל מציינת שהשלב הזה יכול לקחת יותר מכמה שניות, תלוי במשאבים שלה.
- אינדוקס — מה שגוגל רואה ב-HTML שאחרי הרינדור הוא מה שנכנס לאינדקס.
אם התוכן כבר נמצא ב-HTML שהשרת מחזיר, הוא זמין משלב הסריקה. אם הוא נבנה רק בדפדפן, הוא תלוי בכך שהרינדור יצליח — שכל הקבצים ייטענו, שה-API יענה, ושאין שגיאה בקוד.
רינדור בצד השרת מול רינדור בדפדפן
| גישה | מה השרת מחזיר | השפעה על גוגל וגולשים |
|---|---|---|
| רינדור בדפדפן (CSR) | שלד HTML כמעט ריק + קובץ JavaScript | התוכן תלוי ברינדור; טעינה ראשונה איטית יותר |
| רינדור בשרת (SSR) | HTML מלא, ואז JavaScript מוסיף אינטראקטיביות | התוכן זמין מיד לכל סורק ולגולש |
| יצירה מראש (Static / Pre-render) | קבצי HTML שנבנו מראש | הכי מהיר, מתאים לתוכן שלא משתנה כל רגע |
גוגל כותבת שרינדור בצד השרת או יצירה מראש הם עדיין "רעיון מצוין" — כי הם מאיצים את האתר לגולשים ולסורקים, וכי לא כל הבוטים מריצים JavaScript. זה כולל גם מנועי חיפוש אחרים, כלים ששולפים תצוגה מקדימה לרשתות חברתיות, ומערכות בינה מלאכותית שקוראות אתרים.
הכללים שחייבים לשמור
קישורים אמיתיים
גוגל מגלה קישורים רק כשהם אלמנט <a> עם href. כפתור עם onclick שמחליף תוכן הוא לא קישור מבחינתה, והעמוד שאליו הוא מוביל עלול לא להתגלות לעולם. ראו קישורים פנימיים.
כתובות אמיתיות, לא #
ניתוב באפליקציה צריך להשתמש ב-History API, כך שלכל מסך יש כתובת רגילה. כתובות כמו /#/products לא נקראות באופן אמין.
קודי תשובה נכונים
באפליקציית עמוד יחיד, כל כתובת מחזירה בדרך כלל 200 — גם כשהמוצר לא קיים. התוצאה היא soft 404. גוגל ממליצה להפנות לכתובת שמחזירה 404 אמיתי, או להוסיף noindex בעמוד השגיאה.
לא לסמוך על JavaScript כדי להסיר noindex
אם ה-HTML המקורי מכיל noindex, גוגל עשויה לדלג על הרינדור לגמרי — כך שקוד שאמור להסיר את התגית לא ירוץ.
כותרת ותיאור בכל מסך
כל כתובת צריכה <title>, תיאור ותג קנוניקל משלה. באפליקציות רבות כל המסכים נשארים עם הכותרת של דף הבית.
מה זה אומר כשבוחרים טכנולוגיה
לאתר שהמטרה שלו היא להופיע בחיפוש — אתר עסקי, אינדקס, חנות, אתר תוכן — אני בונה כך שהשרת מחזיר HTML מלא, ו-JavaScript מוסיף אינטראקטיביות מעליו. זה נכון לאתרי וורדפרס על תבנית ייעודית וגם למערכות שאני מפתח מאפס. אזורים שלא צריכים להופיע בגוגל — לוח בקרה של משתמש, אזור אישי, ממשק ניהול — יכולים להיות אפליקציה בדפדפן בלי שום בעיה. ההחלטה היא לפי אזור, לא לפי אופנה.
איך בודקים מה גוגל רואה
- בדיקת כתובת ב-Search Console — "בדיקת כתובת בזמן אמת" מציגה את ה-HTML שאחרי הרינדור וצילום מסך. ראו המדריך ל-Search Console.
- "הצג מקור" בדפדפן — מראה את ה-HTML שהשרת החזיר, לפני JavaScript. אם התוכן החשוב לא שם, הוא תלוי ברינדור.
- כיבוי JavaScript בדפדפן — בדיקה גסה אבל מהירה: מה נשאר מהעמוד?
שאלות נפוצות
גוגל לא יודעת לקרוא React?
היא יודעת, אבל זה מוסיף שלב שיכול להיכשל או להתעכב. אתר React עם רינדור בצד השרת לא סובל מהבעיה הזו.
מה עם Next.js ומסגרות דומות?
מסגרות כאלה תומכות ברינדור בצד השרת וביצירה מראש — כלומר הן פתרון לבעיה, בתנאי שמשתמשים באפשרויות האלה ולא רק ברינדור בדפדפן.
וורדפרס הוא אתר JavaScript?
לא. וורדפרס מחזיר HTML מלא מהשרת. אתר וורדפרס יכול להפוך לכבד ב-JavaScript בגלל תוספים ובוני עמודים, אבל התוכן עצמו זמין לגוגל בלי רינדור.
בחירת ארכיטקטורה שגוגל וגולשים יכולים לקרוא היא חלק מהפיתוח אתרים מורכבים שאני עושה. יש לכם אפליקציית אינטרנט שלא נכנסת לאינדקס? ספרו לי על הטכנולוגיה.
אהבתם את המאמר?